
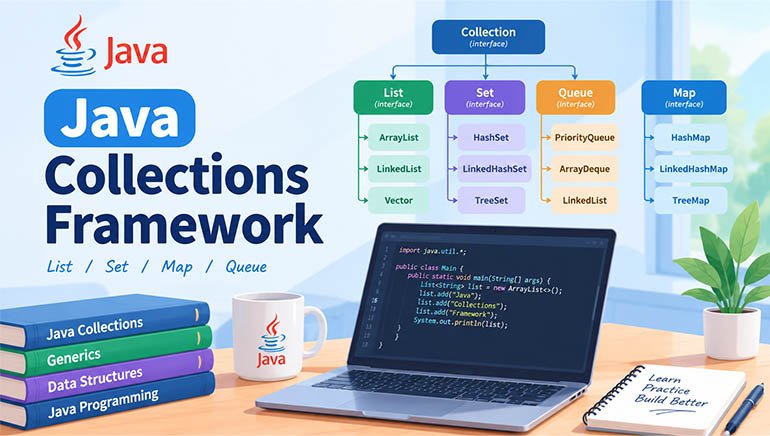
- Tổng quan về Java Collections Framework
- List: ArrayList và LinkedList
- Set: HashSet, LinkedHashSet và TreeSet
- Map: HashMap, LinkedHashMap và TreeMap
- Queue, Deque và các cấu trúc liên quan
- Ví dụ thực chiến 1: ArrayList và Iterator
- Ví dụ thực chiến 2: HashSet và HashMap
- Ví dụ thực chiến 3: Comparable và Comparator
- ConcurrentModificationException và an toàn khi duyệt
- Độ phức tạp thuật toán và lựa chọn Collection
- Best Practices trong dự án thực tế
- Bài tập thực hành và tổng kết
Java Collections Framework (JCF) là một trong những nền tảng quan trọng nhất của lập trình Java. Hầu hết ứng dụng Java thực tế đều phải quản lý dữ liệu dưới dạng danh sách người dùng, tập hợp quyền truy cập, bảng ánh xạ mã sản phẩm, hàng đợi xử lý công việc hoặc dữ liệu cần sắp xếp. Nếu chỉ biết gọi add(), remove() hay get(), bạn mới chỉ sử dụng bề mặt của JCF. Để viết phần mềm hiệu quả, bạn cần hiểu cấu trúc dữ liệu nằm bên dưới mỗi implementation, cách Java tìm kiếm phần tử, quản lý bộ nhớ, xử lý va chạm và lựa chọn thuật toán phù hợp.
Bài giảng này đi từ kiến trúc interface đến cơ chế triển khai bên trong, sau đó chuyển sang các chương trình Java có thể biên dịch và chạy trực tiếp. Các ví dụ sử dụng cú pháp Java hiện đại, phù hợp với Java 8 trở lên, đồng thời chỉ rõ những điểm khác biệt đáng chú ý trong OpenJDK.
1. Phân biệt được interface và implementation trong JCF.
2. Hiểu ArrayList, LinkedList, HashSet, TreeSet, HashMap và TreeMap hoạt động ra sao.
3. Biết phân tích độ phức tạp thời gian và chi phí bộ nhớ của các cấu trúc dữ liệu.
4. Tự viết, biên dịch và kiểm chứng các chương trình Java thực tế.
5. Tránh những lỗi phổ biến liên quan đến equals(), hashCode(), thứ tự duyệt và sửa đổi Collection.
1. Tổng quan về Java Collections Framework
Java Collections Framework là một hệ thống gồm các interface, lớp triển khai và thuật toán dùng để lưu trữ, truy xuất, tìm kiếm, sắp xếp và thao tác với nhóm đối tượng. JCF được cung cấp chủ yếu trong gói java.util; những cấu trúc phục vụ xử lý đồng thời thường nằm trong java.util.concurrent.
Hãy tưởng tượng một ứng dụng thương mại điện tử. Bạn cần danh sách sản phẩm trong giỏ hàng, tập hợp mã khuyến mãi không trùng lặp và bảng tra cứu sản phẩm theo mã. Ba bài toán này có bản chất khác nhau, nên Java cung cấp những cấu trúc dữ liệu khác nhau để giải quyết chúng.
1.1. Collection là gì? Tại sao cần JCF?
Trước khi có Collection, lập trình viên có thể sử dụng mảng để lưu trữ nhiều phần tử:
public class Main {
    public static void main(String[] args) {
        String[] names = new String[3];

        names[0] = "An";
        names[1] = "Binh";
        names[2] = "Chi";

        for (String name : names) {
            System.out.println(name);
        }
    }
}
Mảng có ưu điểm là truy cập theo chỉ số nhanh, bộ nhớ tương đối gọn và kiểu dữ liệu rõ ràng. Tuy nhiên, kích thước mảng cố định sau khi tạo. Nếu mảng đã đầy, bạn phải tự tạo mảng mới và sao chép dữ liệu. Mảng cũng không cung cấp sẵn các thao tác như khử trùng lặp, sắp xếp theo comparator hoặc tìm kiếm theo khóa.
JCF cung cấp các lớp đã đóng gói những thao tác này. Ví dụ, ArrayList tự quản lý mảng bên trong, HashSet hỗ trợ kiểm tra phần tử trùng lặp theo quy tắc băm và HashMap cho phép ánh xạ khóa sang giá trị.
| Tiêu chí | Mảng (Array) | Java Collection |
|---|---|---|
| Kích thước | Cố định sau khi tạo | Nhiều implementation tự tăng hoặc giảm số phần tử logic |
| Truy cập theo chỉ số | O(1) | Phụ thuộc implementation; ArrayList là O(1) |
| Khử trùng lặp | Phải tự xử lý | Set cung cấp ngữ nghĩa không trùng lặp |
| Tìm kiếm theo khóa | Phải tự xây dựng | Map cung cấp các thao tác tra cứu theo khóa |
| Sắp xếp | Dùng Arrays.sort() | Có thể dùng Collections.sort(), TreeSet, TreeMap... |
| Kiểu dữ liệu | Có thể là kiểu nguyên thủy hoặc tham chiếu | Lưu đối tượng; kiểu nguyên thủy được boxing thành wrapper |
Lưu ý rằng Collection không phải lúc nào cũng tốt hơn mảng. Khi biết chính xác kích thước, cần lưu dữ liệu kiểu nguyên thủy với chi phí bộ nhớ thấp hoặc cần biểu diễn dữ liệu dạng ma trận, mảng vẫn là lựa chọn phù hợp. JCF hữu ích khi cần một API quản lý dữ liệu linh hoạt và giàu chức năng.
1.2. Sơ đồ phân cấp các interface
Điểm quan trọng đầu tiên là phân biệt interface mô tả hành vi với class triển khai cấu trúc dữ liệu. Interface cho biết đối tượng có thể làm gì; implementation quyết định dữ liệu được lưu trữ và xử lý như thế nào.
Iterable<E>
   |
   +-- Collection<E>
         |
         +-- List<E>        : Có thứ tự, cho phép phần tử trùng lặp
         |     |
         |     +-- ArrayList<E>
         |     +-- LinkedList<E>
         |     +-- Vector<E> (legacy)
         |
         +-- Set<E>         : Không chứa các phần tử trùng theo ngữ nghĩa Set
         |     |
         |     +-- HashSet<E>
         |     +-- LinkedHashSet<E>
         |     +-- SortedSet<E>
         |            |
         |            +-- NavigableSet<E>
         |                   |
         |                   +-- TreeSet<E>
         |
         +-- Queue<E>       : Hàng đợi xử lý phần tử
               |
               +-- Deque<E> : Thêm/xóa ở cả hai đầu
                     |
                     +-- ArrayDeque<E>
                     +-- LinkedList<E>

Map<K, V>  [Nhánh độc lập, không kế thừa Collection]
   |
   +-- HashMap<K, V>
   +-- LinkedHashMap<K, V>
   +-- SortedMap<K, V>
          |
          +-- NavigableMap<K, V>
                 |
                 +-- TreeMap<K, V>

Các lớp hỗ trợ xử lý đồng thời:
   +-- ConcurrentHashMap<K, V>
   +-- ConcurrentSkipListMap<K, V>
   +-- CopyOnWriteArrayList<E>
   +-- ConcurrentLinkedQueue<E>
Iterable cho phép một đối tượng cung cấp Iterator, nhờ đó có thể sử dụng vòng lặp nâng cao for-each. Collection mở rộng khả năng đó bằng các thao tác quản lý một nhóm phần tử như thêm, xóa và kiểm tra sự tồn tại.
List, Set và Queue đều thuộc nhánh Collection. Ngược lại, Map không kế thừa Collection vì nó quản lý các cặp khóa-giá trị, chứ không phải một tập phần tử theo cùng mô hình.
Collections là lớp tiện ích, còn Collection là interface.
1.2.1. Phân biệt Collection, Collections và Map
| Tên | Loại | Vai trò |
|---|---|---|
| Collection<E> | Interface | Mô tả các thao tác chung với nhóm phần tử |
| Collections | Utility class | Chứa thuật toán và wrapper như sort(), unmodifiableList(), synchronizedList() |
| Map<K,V> | Interface độc lập | Ánh xạ khóa sang giá trị |
| ArrayList<E> | Class | Triển khai List dựa trên mảng động |
1.3. Generics, Iterator và các quy tắc chung
Generics cho phép xác định kiểu dữ liệu mà Collection quản lý. Ví dụ, List<String> biểu diễn danh sách chuỗi, còn Map<Long, User> biểu diễn ánh xạ từ mã số sang đối tượng User.
import java.util.ArrayList;
import java.util.List;

public class Main {
    public static void main(String[] args) {
        List<String> names = new ArrayList<>();

        names.add("An");
        names.add("Binh");

        String first = names.get(0);

        System.out.println(first);
        System.out.println(names.size());

        // names.add(100); // Lỗi biên dịch: sai kiểu dữ liệu
    }
}
Generics giúp trình biên dịch phát hiện nhiều lỗi kiểu dữ liệu trước khi chạy. Tuy nhiên, do type erasure, thông tin kiểu generic thông thường không được giữ nguyên đầy đủ ở runtime như một kiểu tham số hóa riêng biệt.
Một số quy tắc chung cần nhớ:
- Phần lớn Collection chuẩn không đồng bộ hóa nội bộ. Không mặc định rằng nhiều thread có thể cùng sửa dữ liệu an toàn.
- Không thể dùng kiểu nguyên thủy trực tiếp làm tham số generic. Dùng
Integer,Long,Doublethay choint,long,double. - Phần lớn Collection cho phép lưu giá trị tham chiếu
null, nhưng điều này phụ thuộc implementation. Ví dụ,ArrayDequekhông cho phép null. - Các Collection thông thường lưu tham chiếu đến đối tượng, không tự động sao chép sâu đối tượng đó.
- Chỉ nên lập trình dựa trên thứ tự duyệt nếu hợp đồng của interface hoặc implementation bảo đảm thứ tự đó.
2. List: ArrayList và LinkedList
List là interface dành cho dữ liệu có thứ tự. Một List có thể chứa nhiều phần tử bằng nhau và thường cho phép truy cập theo chỉ số từ 0 đến size() - 1.
Hai implementation phổ biến nhất là ArrayList và LinkedList. Chúng cùng triển khai List nhưng sử dụng hai cấu trúc dữ liệu hoàn toàn khác nhau.
2.1. ArrayList dưới mui xe: Dynamic Array
ArrayList quản lý một mảng tham chiếu bên trong. Trong OpenJDK, mảng này được gọi là elementData. Có thể hình dung cấu trúc của nó như sau:
ArrayList: size = 4, capacity = 6

Index:        0        1        2        3        4        5
          +--------+--------+--------+--------+--------+--------+
elementData | "A"  | "B"    | "C"    | "D"    | null   | null   |
          +--------+--------+--------+--------+--------+--------+
              <----------- Phần tử đang sử dụng ---------->
              <---------------- Capacity ----------------->

size = số phần tử logic đang chứa
capacity = độ dài mảng bên trong hiện tại
Điểm mấu chốt là size và capacity không giống nhau. Size cho biết có bao nhiêu phần tử đang được lưu; capacity cho biết mảng nội bộ chứa được bao nhiêu tham chiếu trước khi cần mở rộng.
2.1.1. Khi thêm phần tử, ArrayList làm gì?
Khi gọi add(element), ArrayList kiểm tra xem mảng bên trong còn chỗ hay không. Nếu còn chỗ, phần tử được ghi vào vị trí tiếp theo và size tăng lên. Nếu mảng đã đầy, ArrayList phải cấp phát một mảng mới lớn hơn rồi sao chép các tham chiếu cũ sang mảng mới.
Bước 1: Mảng hiện tại đã đầy
[A] [B] [C] [D]
 size = capacity = 4

Bước 2: Yêu cầu thêm "E"
Cần thêm sức chứa

Bước 3: Tạo mảng mới lớn hơn
[A] [B] [C] [D] [ ] [ ]

Bước 4: Sao chép tham chiếu và ghi phần tử mới
[A] [B] [C] [D] [E] [ ]
 size = 5, capacity = 6
Trong các phiên bản OpenJDK hiện đại, chiến lược tăng capacity của ArrayList thường mở rộng lên khoảng 1,5 lần capacity cũ. Đây là chi tiết triển khai, không phải một bảo đảm của interface List. Nếu capacity cũ bằng 4, capacity mới có thể là 6; nếu bằng 10, có thể là 15.
Độ phức tạp của thao tác thêm phần tử vào cuối:
- Amortized O(1): chi phí trung bình trên một chuỗi nhiều lần thêm phần tử.
- O(n): khi một lần thêm buộc phải mở rộng và sao chép n tham chiếu.
Vì sao vẫn gọi là O(1) trung bình? Mỗi lần mở rộng có thể tốn nhiều thời gian, nhưng capacity tăng theo cấp số nhân. Khi cộng tổng chi phí sao chép qua nhiều lần thêm, tổng số tham chiếu được sao chép vẫn tỷ lệ tuyến tính với số phần tử được thêm. Do đó, chi phí trung bình trên mỗi lần thêm là hằng số.
2.1.2. Chi phí của các thao tác phổ biến
| Thao tác | Độ phức tạp điển hình | Giải thích |
|---|---|---|
| get(index) | O(1) | Tính trực tiếp vị trí trong mảng |
| set(index, value) | O(1) | Thay tham chiếu tại một vị trí |
| add(value) cuối danh sách | Amortized O(1) | Thỉnh thoảng phải mở rộng mảng |
| add(index, value) | O(n) | Có thể phải dịch chuyển các phần tử phía sau |
| remove(index) | O(n) | Có thể phải dịch chuyển phần đuôi sang trái |
| contains(value) | O(n) | Tìm kiếm tuyến tính theo equals() |
Ví dụ, khi thêm phần tử vào đầu danh sách, ArrayList phải dịch chuyển các tham chiếu hiện có sang phải để tạo chỗ trống. Khi xóa phần tử ở giữa, các tham chiếu phía sau phải dịch chuyển sang trái.
Để hạn chế việc mở rộng nhiều lần khi đã biết trước quy mô dữ liệu, có thể khởi tạo với capacity phù hợp:
import java.util.ArrayList;
import java.util.List;

public class Main {
    public static void main(String[] args) {
        int expectedSize = 100_000;

        List<Integer> numbers =
                new ArrayList<>(expectedSize);

        for (int i = 0; i < expectedSize; i++) {
            numbers.add(i);
        }

        System.out.println(numbers.size());
    }
}
Khởi tạo new ArrayList<>(expectedSize) chỉ tạo sức chứa ban đầu; nó không tạo sẵn expectedSize phần tử. Vì vậy, gọi get(0) ngay sau khi tạo danh sách rỗng vẫn gây IndexOutOfBoundsException.
2.2. LinkedList: Cấu trúc Node kép
LinkedList triển khai danh sách liên kết kép (doubly linked list). Mỗi Node lưu tham chiếu đến phần tử và hai tham chiếu liên kết với Node trước, Node sau.
first                                      last
  |                                          |
  v                                          v
+------+------+------+    +------+------+------+    +------+------+------+
| prev | data | next | <-> | prev | data | next | <-> | prev | data | next |
+------+------+------+    +------+------+------+    +------+------+------+
       Node A                    Node B                    Node C

Node A.prev = null
Node A.next = Node B
Node B.prev = Node A
Node B.next = Node C
Node C.next = null
Trong OpenJDK, mỗi Node của LinkedList chứa một tham chiếu phần tử và hai tham chiếu liên kết. Ngoài các Node, LinkedList còn quản lý các thông tin như first, last và size. Điều này tạo ra chi phí bộ nhớ lớn hơn so với một mảng chỉ lưu các tham chiếu phần tử.
2.2.1. Thêm và xóa Node
Khi thêm phần tử vào đầu hoặc cuối, LinkedList có thể tạo một Node mới và điều chỉnh một số liên kết. Với Node cần xóa đã được xác định, việc tháo Node khỏi danh sách cũng chỉ cần cập nhật các liên kết lân cận.
Tuy nhiên, nếu chỉ có một giá trị và cần tìm vị trí chứa giá trị đó, LinkedList phải duyệt danh sách. Vì vậy, cần phân biệt chi phí thay đổi liên kết với chi phí tìm đến vị trí cần thay đổi.
- Thêm/xóa ở đầu hoặc cuối: O(1) trong điều kiện thông thường.
- get(index): O(n) do phải lần theo liên kết từ một đầu danh sách.
- contains(value): O(n).
- Thêm hoặc xóa tại vị trí index: O(n) để tìm vị trí, cộng chi phí cập nhật liên kết O(1).
- Thêm/xóa thông qua Iterator đang đứng đúng vị trí: thao tác liên kết thường là O(1), không tính chi phí di chuyển Iterator đến đó.
Đừng nhầm rằng LinkedList luôn xóa phần tử ở giữa nhanh hơn ArrayList. Nếu bạn gọi remove(50000) trên danh sách có 100.000 phần tử, LinkedList vẫn phải tìm Node tương ứng trước khi xóa.
2.3. So sánh và lựa chọn List
| Tiêu chí | ArrayList | LinkedList |
|---|---|---|
| Cấu trúc | Mảng tham chiếu động | Danh sách liên kết kép |
| get(index) | O(1) | O(n) |
| Thêm cuối | Amortized O(1) | O(1) |
| Thêm đầu | O(n) | O(1) |
| Xóa phần tử ở giữa | O(n) do dịch chuyển | O(n) nếu phải tìm Node theo index |
| Bộ nhớ | Thường gọn hơn | Tốn thêm bộ nhớ cho liên kết Node |
| Truy cập tuần tự | Thường tận dụng cache CPU tốt | Các Node có thể nằm rải rác trong heap |
| Trường hợp phù hợp | Danh sách thông thường, truy cập theo index | Thêm/xóa ở hai đầu, hoặc thao tác qua Iterator tại vị trí đã biết |
Trong nhiều ứng dụng, ArrayList là lựa chọn mặc định hợp lý cho List. Mảng liên tục thường thân thiện với cache CPU hơn cấu trúc Node rải rác, đồng thời có chi phí bộ nhớ thấp hơn. LinkedList có ưu thế trong một số mô hình thao tác ở hai đầu hoặc khi đã có vị trí Iterator thích hợp, nhưng không nên chọn chỉ vì nghe nói xóa nhanh.
3. Set: HashSet, LinkedHashSet và TreeSet
Set biểu diễn tập hợp không chứa các phần tử trùng lặp theo quy tắc xác định phần tử bằng nhau của implementation. Khác với List, Set không cung cấp truy cập theo chỉ số.
Ba implementation phổ biến giải quyết ba yêu cầu khác nhau:
HashSet: ưu tiên thêm, xóa và kiểm tra tồn tại nhanh; không bảo đảm thứ tự duyệt.LinkedHashSet: giữ thứ tự chèn khi duyệt, đồng thời sử dụng cơ chế băm.TreeSet: duy trì thứ tự sắp xếp theo natural ordering hoặc Comparator.
3.1. HashSet và cơ chế hashCode(), equals()
Một chi tiết thú vị là trong OpenJDK, HashSet được triển khai dựa trên HashMap. HashSet không cần tự xây dựng toàn bộ cơ chế băm và xử lý va chạm. Thay vào đó, nó sử dụng phần tử làm khóa trong một HashMap và dùng một đối tượng giả làm giá trị chung.
HashSet<String>
       |
       v
HashMap<String, Object>
       |
       +-- "Java"  -> PRESENT
       +-- "Spring" -> PRESENT
       +-- "SQL"   -> PRESENT

PRESENT là một đối tượng dùng chung làm giá trị giả.
HashSet chỉ quan tâm đến khóa, không cần lưu giá trị nghiệp vụ.
Để hiểu vì sao HashSet loại bỏ được phần tử trùng lặp, cần hiểu hai phương thức quan trọng của mọi đối tượng Java: hashCode() và equals().
hashCode() trả về một giá trị int dùng để hỗ trợ phân nhóm đối tượng. Giá trị này giúp cấu trúc băm xác định khu vực cần tìm kiếm. Nó không phải mã định danh duy nhất của đối tượng.
equals() xác định hai đối tượng có được xem là bằng nhau theo ngữ nghĩa của class hay không.
Hợp đồng bắt buộc là: nếu hai đối tượng bằng nhau theo equals(), chúng phải trả về cùng một giá trị hashCode(). Chiều ngược lại không bắt buộc. Hai đối tượng có cùng hashCode vẫn có thể khác nhau.
3.1.1. Quy trình kiểm tra phần tử trong HashSet
HashSet.add(element)
        |
        v
HashMap.put(element, PRESENT)
        |
        v
Tính hashCode và xử lý hash
        |
        v
Xác định bucket
        |
        v
Bucket đang trống?
   | Có                    | Không
   v                       v
Thêm entry          So sánh hash và equals()
                           |
                    +------+------+
                    |             |
                 Bằng nhau      Khác nhau
                    |             |
                    v             v
              Không thêm       Tiếp tục tìm
              phần tử mới      hoặc thêm entry

add() trả về true nếu Set được thay đổi.
add() trả về false nếu phần tử đã tồn tại.
Về nguyên tắc, thao tác contains() và add() của HashSet thường có thời gian O(1) trung bình khi hàm băm phân bố tốt. Trong trường hợp va chạm bất lợi, chi phí có thể tăng lên. Hiệu năng không chỉ phụ thuộc số phần tử mà còn phụ thuộc chất lượng hashCode và cách các phần tử được phân bố trong bucket.
3.2. LinkedHashSet và TreeSet
3.2.1. LinkedHashSet: Băm kết hợp liên kết thứ tự
LinkedHashSet sử dụng cơ chế băm để quản lý phần tử và duy trì các liên kết phục vụ thứ tự duyệt. Trong implementation OpenJDK, cấu trúc này được xây dựng trên nền HashSet/LinkedHashMap với các entry có liên kết thứ tự.
Ví dụ, khi chèn các phần tử theo thứ tự "Java", "Python", "Go", LinkedHashSet giữ thứ tự duyệt tương ứng, miễn là không có thao tác nào làm thay đổi nội dung theo cách khác. Nếu thêm lại một phần tử đã tồn tại, phần tử đó không được nhân đôi.
3.2.2. TreeSet: Cây đỏ-đen (Red-Black Tree)
TreeSet duy trì các phần tử theo thứ tự sắp xếp. Trong OpenJDK, nó được triển khai dựa trên NavigableMap, thường sử dụng TreeMap và cây đỏ-đen (Red-Black Tree).
Cây đỏ-đen là một cây tìm kiếm nhị phân tự cân bằng. Mỗi Node mang thông tin màu đỏ hoặc đen, đồng thời tuân theo các quy tắc cân bằng để chiều cao cây được giữ ở mức O(log n). Khi thêm hoặc xóa phần tử, cây có thể thực hiện xoay cây (rotation) và đổi màu để duy trì các bất biến.
              20
             /  \
           10    30
          / \    / \
         5  15  25  35

Các giá trị nhỏ hơn Node nằm ở nhánh trái.
Các giá trị lớn hơn Node nằm ở nhánh phải.

Cây đỏ-đen duy trì thêm quy tắc màu và cân bằng.
Đây là sơ đồ tìm kiếm minh họa, không phải mô tả màu Node thực tế.
Các thao tác tìm kiếm, thêm và xóa của TreeSet thường có độ phức tạp O(log n). Bù lại, TreeSet phải duy trì thứ tự nên thường tốn chi phí hơn HashSet.
TreeSet xác định tính duy nhất dựa trên kết quả so sánh. Nếu comparator trả về 0 cho hai đối tượng, TreeSet xem chúng là cùng một phần tử về mặt thứ tự của Set, ngay cả khi equals() trả về false. Vì thế, comparator dùng cho Set cần nhất quán với equals nếu muốn tuân thủ đầy đủ hợp đồng của Set.
3.3. Bẫy khi định nghĩa đối tượng trong Set
Giả sử ta định nghĩa class Employee và đưa đối tượng vào HashSet. Nếu hai Employee có cùng mã nhân viên nhưng được tạo từ hai lần khác nhau, Java không tự hiểu rằng chúng giống nhau. Bạn phải định nghĩa rõ ngữ nghĩa bằng nhau bằng equals() và hashCode().
import java.util.HashSet;
import java.util.Objects;
import java.util.Set;

class Employee {
    private final int id;
    private final String name;

    public Employee(int id, String name) {
        this.id = id;
        this.name = name;
    }

    @Override
    public boolean equals(Object obj) {
        if (this == obj) {
            return true;
        }
        if (!(obj instanceof Employee other)) {
            return false;
        }
        return id == other.id;
    }

    @Override
    public int hashCode() {
        return Objects.hash(id);
    }

    @Override
    public String toString() {
        return id + ":" + name;
    }
}

public class Main {
    public static void main(String[] args) {
        Set<Employee> employees = new HashSet<>();

        employees.add(new Employee(1, "An"));
        employees.add(new Employee(1, "An Nguyen"));
        employees.add(new Employee(2, "Binh"));

        System.out.println(employees.size());
    }
}
Kết quả là 2 vì hai đối tượng có id bằng 1 được xem là bằng nhau, bất kể tên của chúng khác nhau.
2
Ví dụ này sử dụng cú pháp pattern matching cho instanceof, phù hợp với Java 16 trở lên. Nếu sử dụng Java 8, hãy thay đoạn kiểm tra kiểu bằng cú pháp ép kiểu truyền thống.
4. Map: HashMap, LinkedHashMap và TreeMap
Map<K, V> lưu các cặp khóa-giá trị (key-value). Mỗi khóa ánh xạ đến tối đa một giá trị tại một thời điểm. Khi gọi put() với khóa đã tồn tại, giá trị cũ được thay bằng giá trị mới.
Map phù hợp với các bài toán như tra cứu người dùng bằng ID, đếm số lần xuất hiện của từ, lưu cấu hình theo tên thuộc tính hoặc ánh xạ mã sản phẩm đến đối tượng sản phẩm.
4.1. HashMap: Hashing, bucket và collision
HashMap thường sử dụng một mảng các bucket. Mỗi bucket có thể rỗng hoặc chứa một cấu trúc gồm một hay nhiều entry. Entry lưu hash, khóa, giá trị và liên kết đến entry tiếp theo khi cần.
HashMap<String, Integer>

Bucket 0: null
Bucket 1: [hash, "An", 10] -> [hash, "Binh", 20]
Bucket 2: null
Bucket 3: [hash, "Chi", 30]
Bucket 4: null
Bucket 5: [hash, "Dung", 40]

Mỗi bucket là một vị trí trong bảng băm.
Các entry có thể va chạm và cùng nằm trong một bucket.
Sơ đồ chỉ minh họa; vị trí thực tế phụ thuộc hash và capacity.
4.1.1. Từ khóa đến bucket
Khi thực hiện map.put(key, value), HashMap cần xác định vị trí phù hợp cho khóa. Trong OpenJDK, hash được xử lý thêm từ hashCode() để cải thiện việc phân bố các bit trước khi tính chỉ số bucket.
Với một bảng có độ dài là lũy thừa của hai, chỉ số bucket trong implementation thường được tính tương đương với:
bucketIndex = (capacity - 1) & hash
Đây là chi tiết triển khai của HashMap trong OpenJDK, không phải công thức bắt buộc của interface Map. Nó tận dụng đặc tính capacity là lũy thừa của hai để xác định bucket bằng phép toán bit.
4.1.2. Collision là gì?
Collision (va chạm) xảy ra khi hai khóa khác nhau được ánh xạ đến cùng một bucket. Điều này hoàn toàn bình thường: số bucket hữu hạn, trong khi số khóa có thể lớn hơn nhiều.
Ví dụ, hai khóa có thể có hashCode khác nhau nhưng cùng được ánh xạ vào một bucket. Cũng có thể hai khóa khác nhau có hashCode bằng nhau. HashMap phải giải quyết cả hai tình huống.
Khi tìm kiếm một khóa trong bucket, HashMap có thể kiểm tra hash trước rồi so sánh khóa bằng equals(). Hash chỉ giúp thu hẹp phạm vi tìm kiếm; nó không thay thế phép so sánh bằng nhau.
4.2. Collision và cây đỏ-đen từ Java 8
Trong OpenJDK hiện đại, khi nhiều entry va chạm vào cùng một bucket, cấu trúc bên trong thường bắt đầu bằng danh sách liên kết. Nếu bucket trở nên quá dài và đáp ứng các điều kiện triển khai, các entry có thể được chuyển thành cây đỏ-đen (tree bin).
Với HashMap của OpenJDK 8 trở lên, các hằng số triển khai thường gặp là:
TREEIFY_THRESHOLD = 8: ngưỡng liên quan đến việc chuyển bucket thành cây.UNTREEIFY_THRESHOLD = 6: ngưỡng liên quan đến việc chuyển tree bin trở lại danh sách trong quá trình resize.MIN_TREEIFY_CAPACITY = 64: nếu bảng còn quá nhỏ, HashMap thường ưu tiên mở rộng bảng thay vì treeify bucket.
Các giá trị này là chi tiết nội bộ của một implementation cụ thể, không phải cam kết bất biến của API HashMap. Việc treeify còn phụ thuộc số lượng Node thực tế và trạng thái bảng.
put(key, value)
      |
      v
Tính hash và bucket index
      |
      v
Bucket trống?
   | Có                   | Không
   v                      v
Thêm Node             So sánh các Node hiện có
                            |
                            v
                    Khóa đã tồn tại?
                     | Có       | Không
                     v           v
                Cập nhật giá trị  Thêm Node
                                      |
                                      v
                             Bucket đủ điều kiện treeify?
                                | Có       | Chưa
                                v           v
                         Cây đỏ-đen     Danh sách liên kết
                         nếu bảng đủ lớn
Trong điều kiện thông thường, HashMap cung cấp hiệu năng trung bình gần O(1) cho get() và put(). Khi bucket chuyển thành cây, việc tìm kiếm trong cấu trúc đó có thể đạt O(log n) với các điều kiện phù hợp. Tuy nhiên, không nên diễn giải điều này thành bảo đảm rằng mọi tình huống tìm kiếm HashMap luôn có độ phức tạp O(log n).
4.3. Initial capacity, load factor và resize
Hai tham số thường được nhắc đến khi tối ưu HashMap là initialCapacity và loadFactor.
- Initial capacity: mức sức chứa ban đầu được yêu cầu cho bảng băm; nó không phải số phần tử đã lưu.
- Load factor: hệ số xác định mức tải mà bảng được phép đạt đến trước khi cần resize.
- Threshold: ngưỡng phần tử được tính từ capacity và load factor trong implementation.
Với HashMap mặc định, load factor thường là 0.75. Nếu capacity hiện tại là 16, threshold thường bằng:
capacity = 16
loadFactor = 0.75

threshold = capacity * loadFactor
          = 16 * 0.75
          = 12
Khi số entry vượt ngưỡng, HashMap có thể mở rộng bảng, thường tăng capacity lên gấp đôi trong OpenJDK. Các entry sau đó được phân bố lại theo bảng mới. Quá trình này được gọi là resize hoặc rehash theo nghĩa rộng, mặc dù implementation có thể tái sử dụng thông tin hash đã lưu thay vì gọi lại hashCode() cho mọi khóa.
4.3.1. Load factor thấp hay cao tốt hơn?
| Load factor | Ưu điểm | Nhược điểm |
|---|---|---|
| Thấp hơn, ví dụ 0.50 | Ít va chạm hơn trong nhiều tình huống | Tiêu tốn nhiều bộ nhớ bảng hơn |
| 0.75 mặc định | Cân bằng giữa bộ nhớ và hiệu năng trong nhiều trường hợp | Vẫn có thể resize hoặc va chạm |
| Cao hơn, ví dụ 1.00 | Có thể giảm mức sử dụng bộ nhớ cho bảng | Có thể tăng mật độ va chạm và chi phí tra cứu |
Load factor không phải phần trăm dung lượng bộ nhớ heap đang sử dụng. Nó là tỷ lệ giữa số entry và capacity của bảng băm theo cơ chế ngưỡng của implementation.
4.3.2. Khi biết trước số phần tử
import java.util.HashMap;
import java.util.Map;

public class Main {
    public static void main(String[] args) {
        int expectedEntries = 10_000;

        Map<Integer, String> map =
                new HashMap<>(expectedEntries);

        for (int i = 0; i < expectedEntries; i++) {
            map.put(i, "Value-" + i);
        }

        System.out.println(map.size());
        System.out.println(map.get(500));
    }
}
Trong OpenJDK hiện đại, constructor HashMap nhận initial capacity và load factor mặc định 0.75. Khi dự kiến số entry, cần lưu ý rằng initial capacity không nhất thiết bằng chính xác độ dài bảng nội bộ cuối cùng: implementation có thể làm tròn capacity lên lũy thừa của hai và còn áp dụng ngưỡng resize.
Nếu cần tính initial capacity theo số entry dự kiến để giảm nguy cơ resize, một ước lượng lý thuyết là lấy số entry chia cho load factor, rồi làm tròn lên và tính đến giới hạn triển khai. Trong code sản xuất, không nên tự áp dụng công thức mà bỏ qua giới hạn capacity, tràn số nguyên và khác biệt giữa các phiên bản Java.
4.4. HashMap, LinkedHashMap và TreeMap
| Tiêu chí | HashMap | LinkedHashMap | TreeMap |
|---|---|---|---|
| Cấu trúc chính | Bảng băm | Bảng băm kết hợp liên kết thứ tự | Cây tìm kiếm đỏ-đen |
| get/put | O(1) trung bình | O(1) trung bình | O(log n) |
| Thứ tự duyệt | Không bảo đảm | Thứ tự chèn mặc định | Theo thứ tự khóa |
| Khóa null | Cho phép một khóa null | Cho phép một khóa null | Thông thường không cho phép với natural ordering |
| Giá trị null | Cho phép | Cho phép | Cho phép |
| Truy vấn theo khoảng | Không có API sắp xếp theo khoảng | Không có API sắp xếp theo khoảng | Hỗ trợ firstKey(), ceilingKey(), subMap()... |
| Khi nào dùng? | Tra cứu thông thường | Cần thứ tự duyệt ổn định | Cần khóa được sắp xếp và truy vấn theo khoảng |
LinkedHashMap còn có chế độ duyệt theo thứ tự truy cập (access order). Đây là nền tảng để xây dựng những cấu trúc kiểu LRU cache đơn giản bằng cách kết hợp constructor phù hợp và cơ chế loại bỏ entry cũ.
TreeMap hữu ích khi cần lấy khóa nhỏ nhất/lớn nhất, tìm khóa gần nhất với một giá trị hoặc duyệt các khóa trong khoảng. Chẳng hạn, subMap(100, true, 200, false) có thể lấy vùng khóa từ 100 đến nhỏ hơn 200 theo thứ tự so sánh của Map.
5. Queue, Deque và các cấu trúc liên quan
Queue mô hình hóa hàng đợi. Trong mô hình FIFO (First In, First Out), phần tử được thêm trước sẽ được xử lý trước. Deque (Double-Ended Queue) mở rộng ý tưởng này bằng cách cho phép thêm và xóa ở cả hai đầu.
5.1. Queue: offer(), poll() và peek()
Java cung cấp một số cặp phương thức có hành vi khác nhau khi hàng đợi không thể thêm hoặc không còn phần tử:
| Thao tác | Phương thức ưu tiên | Hành vi khi thất bại hoặc rỗng |
|---|---|---|
| Thêm | offer(e) | Trả về false nếu không thể thêm |
| Thêm | add(e) | Có thể ném exception nếu không thể thêm |
| Lấy và xóa đầu hàng đợi | poll() | Trả về null nếu rỗng |
| Lấy và xóa đầu hàng đợi | remove() | Ném exception nếu rỗng |
| Xem phần tử đầu | peek() | Trả về null nếu rỗng |
| Xem phần tử đầu | element() | Ném exception nếu rỗng |
5.2. ArrayDeque và PriorityQueue
ArrayDeque là lựa chọn thường phù hợp cho hàng đợi hai đầu trong môi trường không yêu cầu đồng bộ hóa. Nó sử dụng cấu trúc mảng vòng và không cho phép phần tử null. Có thể sử dụng ArrayDeque để triển khai stack bằng push(), pop() và peek().
PriorityQueue xử lý phần tử theo thứ tự ưu tiên, không nhất thiết theo thứ tự chèn. Implementation phổ biến sử dụng binary heap. Phần tử ưu tiên nhất được lấy ra trước theo natural ordering hoặc Comparator.
import java.util.ArrayDeque;
import java.util.PriorityQueue;
import java.util.Queue;
import java.util.Deque;

public class Main {
    public static void main(String[] args) {
        Queue<String> tasks = new ArrayDeque<>();

        tasks.offer("Task A");
        tasks.offer("Task B");
        tasks.offer("Task C");

        System.out.println(tasks.poll());
        System.out.println(tasks.poll());

        PriorityQueue<Integer> priorities =
                new PriorityQueue<>();

        priorities.offer(30);
        priorities.offer(10);
        priorities.offer(20);

        System.out.println(priorities.poll());
        System.out.println(priorities.poll());

        Deque<String> stack = new ArrayDeque<>();
        stack.push("A");
        stack.push("B");

        System.out.println(stack.pop());
    }
}Task A Task B 10 20 B
Độ phức tạp điển hình của PriorityQueue là O(log n) cho thêm và lấy phần tử ưu tiên nhất; xem phần tử ưu tiên nhất bằng peek() thường là O(1). Duyệt toàn bộ PriorityQueue không bảo đảm trả về các phần tử theo thứ tự ưu tiên. Muốn lấy ra theo thứ tự, hãy poll() lặp lại hoặc tạo bản sao rồi xử lý.
6. Ví dụ thực chiến 1: ArrayList và Iterator
Ví dụ đầu tiên mô phỏng danh sách công việc. Chúng ta sẽ thêm phần tử, sửa giá trị theo index, xóa bằng Iterator và duyệt danh sách sau khi cập nhật.
import java.util.ArrayList;
import java.util.Iterator;
import java.util.List;

public class Main {
    public static void main(String[] args) {
        List<String> tasks = new ArrayList<>();

        // 1. Thêm dữ liệu
        tasks.add("Hoc Java");
        tasks.add("Hoc SQL");
        tasks.add("Lam bai tap");
        tasks.add("On tap Java");

        System.out.println("Ban dau: " + tasks);

        // 2. Sửa phần tử tại index 1
        String oldValue = tasks.set(1, "Hoc PostgreSQL");
        System.out.println("Gia tri cu: " + oldValue);
        System.out.println("Sau khi sua: " + tasks);

        // 3. Xóa phần tử bằng Iterator
        Iterator<String> iterator = tasks.iterator();

        while (iterator.hasNext()) {
            String task = iterator.next();

            if (task.equals("Lam bai tap")) {
                iterator.remove();
            }
        }

        System.out.println("Sau khi xoa: " + tasks);

        // 4. Duyệt danh sách
        System.out.println("Danh sach cuoi cung:");

        for (String task : tasks) {
            System.out.println("- " + task);
        }

        System.out.println("So phan tu: " + tasks.size());
    }
}
Giải thích:
add()thêm phần tử vào cuối danh sách.set(1, ...)thay giá trị tại index 1 và trả về giá trị cũ.iterator.next()lấy phần tử tiếp theo trong quá trình duyệt.iterator.remove()xóa phần tử vừa được Iterator trả về, đồng thời cập nhật trạng thái của Iterator.size()trả về số phần tử đang có trong danh sách.
Hãy chú ý rằng set() khác add(index, value). set() thay thế phần tử hiện có; add(index, value) chèn phần tử mới và dịch chuyển các phần tử phía sau.
javac Main.java
java Main
Ban dau: [Hoc Java, Hoc SQL, Lam bai tap, On tap Java]
Gia tri cu: Hoc SQL
Sau khi sua: [Hoc Java, Hoc PostgreSQL, Lam bai tap, On tap Java]
Sau khi xoa: [Hoc Java, Hoc PostgreSQL, On tap Java]
Danh sach cuoi cung:
- Hoc Java
- Hoc PostgreSQL
- On tap Java
So phan tu: 3
Đây là chương trình độc lập, có thể lưu nguyên nội dung vào file Main.java và chạy bằng JDK đã cài đặt.
7. Ví dụ thực chiến 2: HashSet và HashMap
Trong ví dụ này, chúng ta giải quyết hai bài toán thường gặp: loại bỏ tên trùng lặp và đếm số lần xuất hiện của từng từ. HashSet phù hợp cho việc kiểm tra phần tử duy nhất, còn HashMap phù hợp cho việc lưu kết quả đếm theo khóa.
import java.util.Arrays;
import java.util.HashMap;
import java.util.HashSet;
import java.util.List;
import java.util.Map;
import java.util.Set;

public class Main {
    public static void main(String[] args) {
        // Phần 1: Khử trùng lặp
        List<String> inputNames = Arrays.asList(
                "An", "Binh", "An", "Chi", "Binh", "Dung"
        );

        Set<String> uniqueNames = new HashSet<>(inputNames);

        System.out.println("So ten ban dau: " + inputNames.size());
        System.out.println("So ten duy nhat: " + uniqueNames.size());
        System.out.println("Co ten An? " + uniqueNames.contains("An"));

        // Phần 2: Đếm tần suất từ
        List<String> words = Arrays.asList(
                "java", "sql", "java",
                "spring", "sql", "java"
        );

        Map<String, Integer> frequency = new HashMap<>();

        for (String word : words) {
            frequency.merge(word, 1, Integer::sum);
        }

        System.out.println("Tan suat java: " + frequency.get("java"));
        System.out.println("Tan suat sql: " + frequency.get("sql"));
        System.out.println("Tan suat spring: " + frequency.get("spring"));
    }
}
new HashSet<>(inputNames) khởi tạo tập hợp từ một Collection có sẵn. Những tên được xem là bằng nhau theo equals() chỉ được giữ một lần.
Phương thức Map.merge(key, value, remappingFunction) giúp cập nhật số đếm gọn hơn. Nếu từ chưa tồn tại, giá trị ban đầu là 1. Nếu đã tồn tại, hàm Integer::sum cộng giá trị mới vào số đếm cũ.
Trong ví dụ này, HashSet không bảo đảm thứ tự hiển thị. Chương trình chỉ in kích thước và kết quả tra cứu, không phụ thuộc vào thứ tự các tên trong Set.
javac Main.java
java Main
So ten ban dau: 6
So ten duy nhat: 4
Co ten An? true
Tan suat java: 3
Tan suat sql: 2
Tan suat spring: 1
7.1. Tối ưu việc đếm bằng Map
Với n từ đầu vào và k từ khác nhau, cách đếm bằng HashMap thường có độ phức tạp O(n) trung bình, với giả định các thao tác băm có chi phí trung bình gần O(1). Bộ nhớ sử dụng tỷ lệ với số từ khác nhau, tức khoảng O(k), không phải luôn O(n).
Trong thực tế, kỹ thuật này còn được dùng để đếm số đơn hàng theo trạng thái, số request theo endpoint, số lần xuất hiện của mã lỗi hoặc thống kê từ trong văn bản. Khi dữ liệu lớn, cần tính thêm chi phí bộ nhớ của đối tượng String, Integer và entry, chứ không chỉ đếm số phần tử logic.
8. Ví dụ thực chiến 3: Comparable và Comparator
Khi làm việc với đối tượng nghiệp vụ, đôi khi cần sắp xếp theo nhiều tiêu chí. Ví dụ, danh sách nhân viên có thể được sắp xếp theo lương giảm dần, sau đó theo tên tăng dần.
Java cung cấp hai cơ chế chính:
Comparable<T>: định nghĩa thứ tự tự nhiên ngay trong class thông quacompareTo().Comparator<T>: định nghĩa một quy tắc so sánh riêng biệt bên ngoài class thông quacompare().
8.1. Phân biệt Comparable và Comparator
| Tiêu chí | Comparable | Comparator |
|---|---|---|
| Phương thức | compareTo(other) | compare(a, b) |
| Nơi định nghĩa | Trong class cần so sánh | Ở bên ngoài class hoặc bằng lambda |
| Số quy tắc | Thường biểu diễn thứ tự tự nhiên | Có thể có nhiều comparator khác nhau |
| Trường hợp sử dụng | Đối tượng có một thứ tự mặc định hợp lý | Sắp xếp theo từng nghiệp vụ cụ thể |
8.2. Chương trình sắp xếp nhân viên
import java.util.ArrayList;
import java.util.Comparator;
import java.util.List;

class Employee implements Comparable<Employee> {
    private final int id;
    private final String name;
    private final int salary;

    public Employee(int id, String name, int salary) {
        this.id = id;
        this.name = name;
        this.salary = salary;
    }

    public int getId() {
        return id;
    }

    public String getName() {
        return name;
    }

    public int getSalary() {
        return salary;
    }

    // Thứ tự tự nhiên: ID tăng dần
    @Override
    public int compareTo(Employee other) {
        return Integer.compare(this.id, other.id);
    }

    @Override
    public String toString() {
        return id + " - " + name + " - " + salary;
    }
}

public class Main {
    public static void main(String[] args) {
        List<Employee> employees = new ArrayList<>();

        employees.add(new Employee(3, "Chi", 1800));
        employees.add(new Employee(1, "An", 2500));
        employees.add(new Employee(2, "Binh", 2500));
        employees.add(new Employee(4, "Dung", 1500));

        // Cách 1: Sắp xếp theo Comparable
        employees.sort(null);

        System.out.println("Theo ID:");
        employees.forEach(System.out::println);

        // Cách 2: Lương giảm dần, tên tăng dần
        Comparator<Employee> bySalaryThenName =
                Comparator.comparingInt(Employee::getSalary)
                        .reversed()
                        .thenComparing(Employee::getName);

        employees.sort(bySalaryThenName);

        System.out.println("Theo luong giam dan, ten tang dan:");
        employees.forEach(System.out::println);
    }
}
Trong compareTo(), chúng ta dùng Integer.compare() thay vì phép trừ this.id - other.id. Phép trừ có thể tràn số nguyên khi các giá trị nằm gần giới hạn int; Integer.compare() tránh rủi ro đó.
Comparator thứ hai ghép nhiều tiêu chí. comparingInt() sắp xếp theo lương tăng dần; reversed() đảo thứ tự; thenComparing() dùng tên làm tiêu chí tiếp theo khi lương bằng nhau.
javac Main.java
java Main
Theo ID:
1 - An - 2500
2 - Binh - 2500
3 - Chi - 1800
4 - Dung - 1500
Theo luong giam dan, ten tang dan:
1 - An - 2500
2 - Binh - 2500
3 - Chi - 1800
4 - Dung - 1500
8.3. Dùng TreeSet để duy trì thứ tự tự động
Nếu chỉ cần sắp xếp danh sách một lần, ArrayList kết hợp sort() là lựa chọn tự nhiên. Nếu cần tập hợp luôn được duy trì theo thứ tự sau mỗi lần thêm hoặc xóa, TreeSet có thể phù hợp hơn.
import java.util.Comparator;
import java.util.Set;
import java.util.TreeSet;

public class Main {
    public static void main(String[] args) {
        Set<String> names = new TreeSet<>(
                Comparator.comparingInt(String::length)
                        .thenComparing(Comparator.naturalOrder())
        );

        names.add("Java");
        names.add("Go");
        names.add("Python");
        names.add("SQL");
        names.add("Java");

        System.out.println(names);
    }
}[Go, SQL, Java, Python]
Comparator trong ví dụ sắp xếp theo độ dài chuỗi, sau đó theo thứ tự từ điển. Hai chuỗi chỉ được xem là cùng một phần tử theo quy tắc của TreeSet khi comparator trả về 0. Nếu comparator chỉ so sánh độ dài, các chuỗi khác nhau nhưng cùng độ dài có thể bị xem là trùng. Vì vậy, việc thêm tiêu chí phụ là rất quan trọng.
9. ConcurrentModificationException và an toàn khi duyệt
Một lỗi rất phổ biến khi mới làm việc với Collection là xóa phần tử trực tiếp trong vòng lặp for-each. Điều này có thể dẫn đến ConcurrentModificationException.
9.1. Ví dụ gây lỗi
import java.util.ArrayList;
import java.util.List;

public class Main {
    public static void main(String[] args) {
        List<Integer> numbers =
                new ArrayList<>(
                        List.of(1, 2, 3, 4, 5)
                );

        for (Integer number : numbers) {
            if (number % 2 == 0) {
                numbers.remove(number);
            }
        }

        System.out.println(numbers);
    }
}
Đoạn code trên có thể ném ConcurrentModificationException khi Iterator phát hiện cấu trúc danh sách đã bị sửa đổi ngoài cơ chế mà Iterator cho phép. Vì exception xảy ra trong quá trình thực thi, chương trình không bảo đảm in ra danh sách kết quả.
Với ArrayList, vòng lặp for-each sử dụng Iterator ở bên dưới. Khi gọi numbers.remove(), bạn đang thay đổi danh sách trực tiếp trong khi Iterator vẫn quản lý trạng thái duyệt của riêng nó.
9.2. Cách khắc phục 1: Iterator.remove()
import java.util.ArrayList;
import java.util.Iterator;
import java.util.List;

public class Main {
    public static void main(String[] args) {
        List<Integer> numbers =
                new ArrayList<>(
                        List.of(1, 2, 3, 4, 5)
                );

        Iterator<Integer> iterator = numbers.iterator();

        while (iterator.hasNext()) {
            Integer number = iterator.next();

            if (number % 2 == 0) {
                iterator.remove();
            }
        }

        System.out.println(numbers);
    }
}[1, 3, 5]
Iterator.remove() cập nhật danh sách thông qua cơ chế xóa được Iterator hỗ trợ. Phương thức này chỉ được gọi sau một lần next() hợp lệ và không được gọi lặp lại cho cùng một phần tử nếu chưa có lần next() mới.
9.3. Cách khắc phục 2: removeIf()
Trong Java 8 trở lên, nếu chỉ cần loại bỏ phần tử theo điều kiện, removeIf() thường là cách viết ngắn gọn và dễ đọc hơn.
import java.util.ArrayList;
import java.util.List;

public class Main {
    public static void main(String[] args) {
        List<Integer> numbers =
                new ArrayList<>(
                        List.of(1, 2, 3, 4, 5)
                );

        numbers.removeIf(number -> number % 2 == 0);

        System.out.println(numbers);
    }
}[1, 3, 5]
9.4. Cách khắc phục 3: Dùng Collection hỗ trợ đồng thời
ConcurrentModificationException không nhất thiết có nghĩa là chương trình có nhiều thread. Nó có thể xảy ra ngay trong một thread khi cấu trúc dữ liệu bị sửa đổi ngoài cơ chế được Iterator hỗ trợ.
Nhiều Collection thông thường sử dụng fail-fast iterator: Iterator có thể phát hiện một số thay đổi cấu trúc ngoài dự kiến và ném exception. Tuy nhiên, fail-fast chỉ mang tính phát hiện lỗi theo cơ chế best-effort; không được dựa vào nó như một công cụ đồng bộ hóa hay một bảo đảm phát hiện mọi sửa đổi.
Nếu nhiều thread cần cùng truy cập và cập nhật dữ liệu, phải chọn chiến lược đồng bộ hóa thích hợp. Ví dụ, ConcurrentHashMap hỗ trợ thao tác Map đồng thời, trong khi CopyOnWriteArrayList phù hợp hơn với danh sách có nhiều lần đọc và ít lần ghi.
import java.util.concurrent.ConcurrentHashMap;
import java.util.concurrent.ConcurrentMap;

public class Main {
    public static void main(String[] args) {
        ConcurrentMap<String, Integer> counts =
                new ConcurrentHashMap<>();

        counts.put("Java", 10);
        counts.put("SQL", 5);

        counts.merge("Java", 1, Integer::sum);

        counts.forEach((key, value) ->
                System.out.println(key + ": " + value)
        );
    }
}
Ví dụ trên không minh họa việc xóa phần tử khỏi Map trong lúc duyệt. Nó cho thấy cách sử dụng ConcurrentHashMap để thực hiện thao tác cập nhật số đếm thông qua merge(). Kết quả thứ tự in ra không được bảo đảm.
Java: 11
SQL: 5
ConcurrentHashMap hỗ trợ Iterator có tính weakly consistent: Iterator có thể phản ánh một phần các cập nhật xảy ra trong quá trình duyệt và không ném ConcurrentModificationException chỉ vì những cập nhật đồng thời đó. Tuy nhiên, điều này không đồng nghĩa với snapshot nhất quán tuyệt đối.
10. Độ phức tạp thuật toán và lựa chọn Collection
Big O mô tả cách chi phí thời gian hoặc bộ nhớ tăng lên khi kích thước dữ liệu tăng. Đây là công cụ hữu ích để chọn cấu trúc dữ liệu, nhưng không thể thay thế việc đo hiệu năng thực tế. Hằng số ẩn, cách bố trí bộ nhớ, cache CPU, chất lượng dữ liệu và chi phí tạo đối tượng đều có ảnh hưởng.
10.1. Bảng độ phức tạp tham khảo
Bảng dưới đây mô tả các trường hợp điển hình, không phải cam kết tuyệt đối cho mọi đầu vào hay mọi phiên bản JDK.
| Implementation | Truy cập / tra cứu | Thêm | Xóa | Ghi chú |
|---|---|---|---|---|
| ArrayList | get(index): O(1), contains: O(n) | Cuối: amortized O(1) | Theo index: O(n) | Phù hợp cho truy cập tuần tự và theo index |
| LinkedList | get(index): O(n) | Đầu/cuối: O(1) | Đầu/cuối: O(1) | Không phù hợp với truy cập ngẫu nhiên thường xuyên |
| HashSet | contains: O(1) trung bình | O(1) trung bình | O(1) trung bình | Phụ thuộc chất lượng hashCode và va chạm |
| TreeSet | O(log n) | O(log n) | O(log n) | Giữ phần tử theo thứ tự |
| HashMap | get: O(1) trung bình | put: O(1) trung bình | remove: O(1) trung bình | Không bảo đảm thứ tự |
| LinkedHashMap | O(1) trung bình | O(1) trung bình | O(1) trung bình | Giữ thứ tự duyệt theo cấu hình |
| TreeMap | O(log n) | O(log n) | O(log n) | Hỗ trợ tìm kiếm theo khoảng khóa |
| ArrayDeque | Đầu/cuối: O(1) | Đầu/cuối: amortized O(1) | Đầu/cuối: amortized O(1) | Phù hợp cho stack và queue thông thường |
| PriorityQueue | peek: O(1) | O(log n) | poll: O(log n) | Ưu tiên phần tử nhỏ nhất theo comparator mặc định |
10.2. Chọn cấu trúc theo bài toán thực tế
| Bài toán | Lựa chọn thường phù hợp | Lý do |
|---|---|---|
| Danh sách sản phẩm cần duyệt và truy cập theo index | ArrayList | Truy cập ngẫu nhiên nhanh, ít overhead |
| Loại bỏ mã đơn hàng trùng lặp | HashSet | Kiểm tra tồn tại nhanh trung bình |
| Lưu danh sách duy nhất theo thứ tự chèn | LinkedHashSet | Khử trùng lặp nhưng giữ thứ tự duyệt |
| Lưu các khóa đã sắp xếp | TreeSet | Tự duy trì thứ tự và hỗ trợ truy vấn theo khoảng |
| Tra cứu tài khoản theo ID | HashMap | Tra cứu theo khóa nhanh trung bình |
| Lưu cấu hình và giữ thứ tự khai báo | LinkedHashMap | Thứ tự duyệt ổn định theo thứ tự chèn |
| Tra cứu bản ghi theo khoảng thời gian hoặc khóa có thứ tự | TreeMap | Hỗ trợ ceilingKey(), floorKey(), subMap() |
| Hàng đợi xử lý tác vụ FIFO | ArrayDeque hoặc BlockingQueue phù hợp | ArrayDeque cho một thread; BlockingQueue cho mô hình producer-consumer đồng thời |
| Stack thao tác gần đây | ArrayDeque | push()/pop() rõ ràng, tránh dùng Stack legacy |
| Danh sách đọc nhiều, cập nhật ít giữa các thread | CopyOnWriteArrayList | Iterator đọc trên snapshot; ghi tốn chi phí sao chép mảng |
10.3. Vì sao O(1) chưa chắc luôn nhanh hơn O(log n)?
Big O tập trung vào tốc độ tăng trưởng khi n lớn, không phản ánh đầy đủ hằng số chi phí. Với một tập hợp rất nhỏ, cấu trúc đơn giản có thể hoạt động tốt dù thuật toán tìm kiếm tuyến tính là O(n). Ngược lại, khi số phần tử tăng lên hàng trăm nghìn hoặc hàng triệu, ưu điểm của tra cứu theo băm có thể trở nên rõ rệt.
ArrayList cũng có lợi thế do mảng liên tục trong bộ nhớ thường tận dụng cache CPU tốt. LinkedList phải lần theo các tham chiếu Node, khiến việc truy cập tuần tự có thể tốn nhiều cache miss hơn.
Với ứng dụng thực tế, nếu hiệu năng là yêu cầu quan trọng, hãy đo bằng dữ liệu đại diện. Đối với benchmark Java nghiêm túc, nên cân nhắc JMH (Java Microbenchmark Harness), tránh kết luận từ một vòng lặp đo thời gian đơn giản vì JIT compilation, warm-up, garbage collection và các yếu tố môi trường có thể làm kết quả sai lệch.
11. Best Practices trong dự án thực tế
11.1. Khai báo biến theo interface
Thay vì gắn chặt code với một implementation khi không cần thiết, hãy ưu tiên khai báo theo interface:
import java.util.ArrayList;
import java.util.HashMap;
import java.util.HashSet;
import java.util.List;
import java.util.Map;
import java.util.Set;

public class Main {
    public static void main(String[] args) {
        List<String> names = new ArrayList<>();
        Set<String> roles = new HashSet<>();
        Map<Long, String> users = new HashMap<>();

        names.add("An");
        roles.add("ADMIN");
        users.put(1001L, "An");

        System.out.println(names);
        System.out.println(roles);
        System.out.println(users);
    }
}
Cách khai báo này làm giảm sự phụ thuộc vào implementation cụ thể, giúp việc thay đổi cấu trúc dữ liệu dễ dàng hơn. Tuy nhiên, nếu nghiệp vụ phụ thuộc vào tính năng riêng của implementation, hãy thể hiện yêu cầu đó rõ ràng thay vì cố ép mọi thứ về một interface quá chung.
11.2. Tránh sử dụng sai equals() và hashCode()
- Nếu override equals(), thông thường phải override hashCode() tương ứng.
- Không sử dụng những trường có thể thay đổi làm thành phần hash của khóa đang nằm trong HashMap hoặc HashSet.
- Chỉ dùng TreeSet hoặc TreeMap khi thứ tự so sánh của khóa được xác định rõ.
- Kiểm tra comparator có trả về 0 cho hai đối tượng mà nghiệp vụ muốn phân biệt hay không.
- Đối với khóa nghiệp vụ, cân nhắc dùng kiểu bất biến như String, UUID hoặc một value object bất biến.
11.3. Dùng removeIf(), computeIfAbsent() và merge()
Java cung cấp các phương thức giúp thao tác với Collection và Map an toàn, rõ ràng hơn.
import java.util.ArrayList;
import java.util.HashMap;
import java.util.List;
import java.util.Map;

public class Main {
    public static void main(String[] args) {
        List<String> names = new ArrayList<>(
                List.of("An", "", "Binh", "", "Chi")
        );

        names.removeIf(String::isEmpty);

        Map<String, List<String>> groups =
                new HashMap<>();

        groups.computeIfAbsent("Backend",
                key -> new ArrayList<>()).add("Java");

        groups.computeIfAbsent("Backend",
                key -> new ArrayList<>()).add("Spring");

        Map<String, Integer> counts = new HashMap<>();
        counts.merge("Java", 1, Integer::sum);
        counts.merge("Java", 1, Integer::sum);

        System.out.println(names);
        System.out.println(groups);
        System.out.println(counts);
    }
}[An, Binh, Chi]
{Backend=[Java, Spring]}
{Java=2}
computeIfAbsent() phù hợp khi cần khởi tạo giá trị cho khóa chưa tồn tại. merge() phù hợp với các bài toán tích lũy hoặc kết hợp giá trị. Với Map đồng thời, hãy xem xét hợp đồng đồng thời của implementation đang dùng và tránh giả định rằng một chuỗi nhiều lời gọi riêng lẻ luôn tạo thành một giao dịch nguyên tử.
11.4. Phân biệt unmodifiable và immutable
Một danh sách không cho phép sửa qua một tham chiếu không đồng nghĩa với việc mọi đối tượng bên trong đều bất biến. Ví dụ, Collections.unmodifiableList(list) tạo một wrapper không cho phép sửa danh sách thông qua wrapper đó. Nếu code khác vẫn sửa danh sách gốc, wrapper có thể phản ánh những thay đổi ấy.
Trong Java 9 trở lên, các phương thức như List.of(), Set.of() và Map.of() tạo các collection không cho phép thêm, xóa hoặc thay thế phần tử thông qua API thông thường. Chúng không biến các đối tượng có thể thay đổi bên trong thành đối tượng bất biến sâu.
11.5. Tránh null không cần thiết
Khả năng chấp nhận null khác nhau giữa các implementation. Chẳng hạn, HashMap cho phép một khóa null, còn ConcurrentHashMap không cho phép khóa hoặc giá trị null. TreeMap với natural ordering thông thường không chấp nhận khóa null.
Nếu null mang ý nghĩa nghiệp vụ rõ ràng, hãy xác định cách xử lý thống nhất. Nếu không, cân nhắc loại bỏ null khỏi dữ liệu đầu vào để giảm lỗi phát sinh trong các bước xử lý tiếp theo.
11.6. Chọn Collection đồng thời đúng nhu cầu
Không có một cấu trúc đồng thời nào phù hợp với mọi tình huống. Cần xem xét số lượng thread, tỷ lệ đọc/ghi, yêu cầu nhất quán và khả năng chấp nhận độ trễ.
| Implementation | Đặc điểm | Phù hợp khi |
|---|---|---|
| ConcurrentHashMap | Map đồng thời, thao tác nguyên tử ở các API hỗ trợ | Nhiều thread tra cứu và cập nhật theo khóa |
| CopyOnWriteArrayList | Thay đổi tạo bản sao mảng mới | Đọc nhiều, ghi ít |
| ConcurrentLinkedQueue | Hàng đợi liên kết không chặn | Trao đổi phần tử giữa các thread khi không cần cơ chế blocking |
| ArrayBlockingQueue | Hàng đợi giới hạn dung lượng, hỗ trợ blocking | Producer-consumer có backpressure |
| BlockingQueue | Interface cho hàng đợi có các thao tác chờ | Pipeline xử lý công việc đa luồng |
12. Bài tập thực hành và tổng kết
12.1. Bài tập 1: Khử trùng lặp nhưng giữ thứ tự
Cho danh sách các mã sản phẩm: SP01, SP03, SP01, SP02, SP03, SP04. Hãy tạo một cấu trúc chỉ giữ mã duy nhất nhưng vẫn giữ thứ tự xuất hiện lần đầu.
Gợi ý: sử dụng LinkedHashSet. Kết quả mong đợi:
[SP01, SP03, SP02, SP04]
12.2. Bài tập 2: Đếm tần suất từ
Cho một danh sách các từ trong câu. Hãy xây dựng Map để đếm số lần mỗi từ xuất hiện. Mở rộng chương trình để chuẩn hóa chữ hoa/chữ thường bằng toLowerCase() và xử lý dấu câu trước khi đếm.
Yêu cầu: giải thích vì sao dùng HashMap phù hợp hơn ArrayList trong việc tra cứu và cập nhật số đếm theo từ.
12.3. Bài tập 3: Quản lý sinh viên
Tạo class Student gồm mã sinh viên, họ tên và điểm trung bình. Sau đó thực hiện các yêu cầu:
- Lưu danh sách sinh viên bằng ArrayList.
- Sắp xếp theo điểm trung bình giảm dần.
- Nếu điểm bằng nhau, sắp xếp theo tên tăng dần.
- Tìm sinh viên theo mã bằng HashMap.
- Loại bỏ sinh viên trùng mã và giải thích cách định nghĩa equals(), hashCode().
12.4. Bài tập 4: Mô phỏng hàng đợi công việc
Sử dụng ArrayDeque để mô phỏng hàng đợi FIFO. Thêm năm tác vụ, lấy ra hai tác vụ đầu tiên và in trạng thái hàng đợi sau mỗi thao tác. Tiếp theo, thay Queue bằng PriorityQueue để so sánh sự khác nhau giữa thứ tự xử lý FIFO và thứ tự ưu tiên.
12.5. Checklist tự đánh giá
✓ Vì sao Map không kế thừa Collection.
✓ Vì sao ArrayList có truy cập theo index O(1) nhưng chèn giữa thường là O(n).
✓ Vì sao LinkedList có thể xóa Node trong O(1) nhưng remove(index) vẫn là O(n).
✓ Vì sao HashSet cần hashCode() và equals().
✓ Vì sao HashMap có thể xảy ra collision và resize.
✓ Vì sao TreeSet có thể xem hai đối tượng là trùng nhau dựa trên Comparator.
✓ Khi nào nên dùng LinkedHashMap, TreeMap, ArrayDeque và PriorityQueue.
✓ Vì sao ConcurrentModificationException có thể xảy ra trong một thread.
✓ Cách chọn Collection dựa trên yêu cầu truy cập, thứ tự, tính duy nhất và đồng thời.
12.6. Tổng kết kiến trúc JCF
Để lựa chọn Collection đúng, hãy bắt đầu từ yêu cầu nghiệp vụ thay vì chọn lớp quen thuộc nhất. Nếu cần danh sách có thứ tự và truy cập nhanh theo index, hãy nghĩ đến ArrayList. Nếu cần khử trùng lặp, hãy cân nhắc HashSet; nếu cần duy trì thứ tự chèn, dùng LinkedHashSet; nếu cần thứ tự sắp xếp, dùng TreeSet.
Nếu cần tra cứu theo khóa, HashMap thường là lựa chọn mặc định. LinkedHashMap phù hợp khi thứ tự duyệt quan trọng, còn TreeMap phù hợp khi khóa cần được sắp xếp và cần truy vấn theo khoảng. Với hàng đợi, ArrayDeque phù hợp cho các thao tác hai đầu thông thường, trong khi PriorityQueue xử lý theo độ ưu tiên.
Bạn cần lưu dữ liệu như thế nào?

1. Danh sách có thứ tự và cho phép trùng?
   -> ArrayList là lựa chọn mặc định hợp lý.

2. Tập hợp không trùng?
   -> HashSet
   -> LinkedHashSet nếu cần thứ tự chèn
   -> TreeSet nếu cần thứ tự sắp xếp

3. Tra cứu theo khóa?
   -> HashMap
   -> LinkedHashMap nếu cần thứ tự duyệt
   -> TreeMap nếu cần khóa có thứ tự

4. Hàng đợi?
   -> ArrayDeque cho FIFO hoặc thao tác hai đầu
   -> PriorityQueue cho xử lý theo độ ưu tiên
   -> BlockingQueue cho producer-consumer đồng thời

5. Nhiều thread cùng truy cập?
   -> Chọn cấu trúc đồng thời theo yêu cầu nhất quán,
      tỷ lệ đọc/ghi và cách phối hợp thread.
Java Collections Framework không đơn thuần là một tập hợp các API tiện dụng. Nó là sự kết hợp giữa thiết kế hướng interface, các cấu trúc dữ liệu kinh điển, thuật toán và những quy tắc nhất quán về đối tượng. Khi hiểu cơ chế bên dưới, bạn sẽ biết tại sao một thao tác nhanh ở cấu trúc này lại chậm ở cấu trúc khác, khi nào một thay đổi có thể gây lỗi và cách chọn cấu trúc phù hợp với quy mô dữ liệu thực tế.
Điều quan trọng nhất cần ghi nhớ: hãy chọn cấu trúc dữ liệu theo cách bạn cần truy cập, cập nhật và tổ chức dữ liệu. Khi lựa chọn đó đúng, code thường đơn giản hơn, hiệu năng tốt hơn và dễ bảo trì hơn ngay từ đầu.